
你有没有想过,一个机器人要扔掉一个空罐子,光靠"看"够不够?
答案是不够。一个封了口的可乐罐和一个插着吸管、已经喝空的可乐罐,长得几乎一样。人类会怎么做?拿起来晃一晃,感觉一下轻重,立刻就知道该不该扔。可现在市面上那些能叠衣服、能整理桌子的机器人大脑,看再多的图片,也猜不出罐子里到底还有没有可乐。
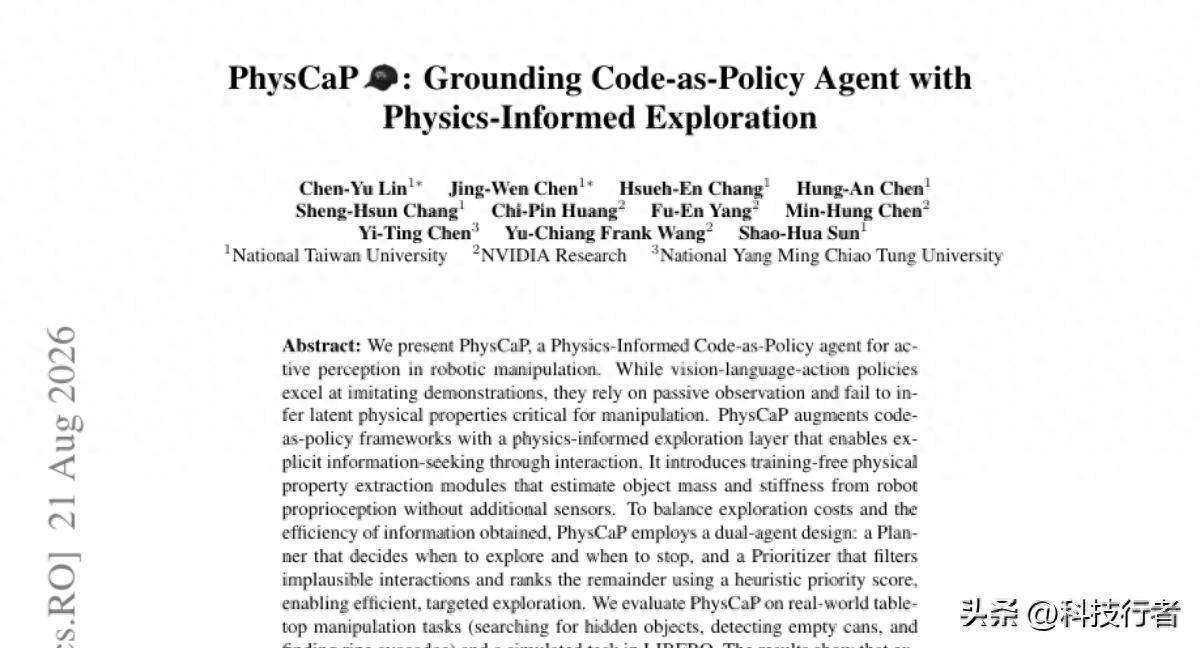
这不是一个小问题。它揭示了当前机器人智能一个挺尴尬的短板:只会"看",不会"摸"。而这篇来自台湾大学、NVIDIA Research 等团队联合完成的论文,提出了一个叫 PhysCaP 的系统,试图把这个短板补上。
视觉智能的天花板:看得懂,但摸不着底
先说说现在最火的机器人技术能做到什么程度。
视觉-语言-动作模型
(VLA,Vision-Language-Action Model:一种直接把摄像头看到的画面和文字指令翻译成机器人动作指令的AI模型)
比如 RT-2、OpenVLA、π0.5这些模型,靠着海量的示范数据训练,已经能完成叠衣服、摆放物体这类相当复杂的操作任务。听起来很厉害对吧?但问题在于,这些模型本质上是在模仿人类做过的动作,它们学的是"看到这个场景该做什么动作
科元网提示:文章来自网络,不代表本站观点。