
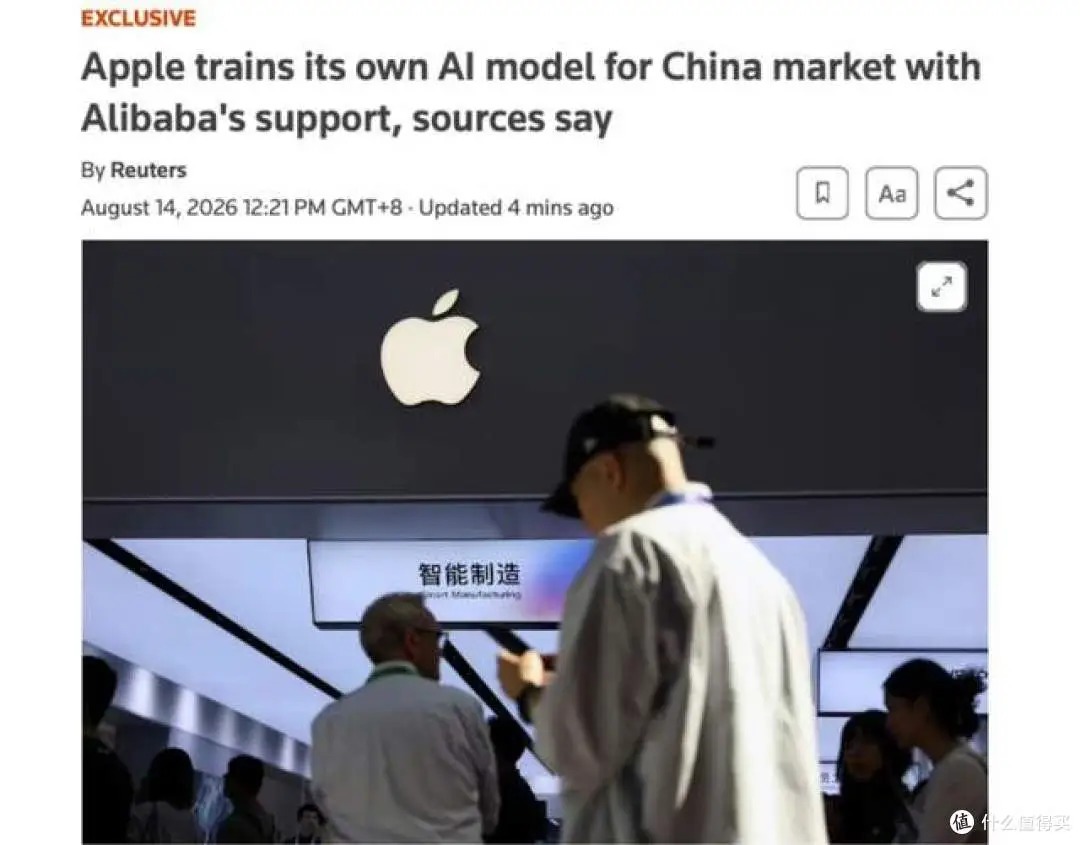
苹果真在搞“中国特供AI”了——不是简单贴个中文翻译,也不是把国外模型塞进App里糊弄事。路透社8月14日那条独家消息,三名匿名但靠谱的知情人士放出来的,说苹果正和阿里一起训练一款专为中国市场打造的大模型。这不是外包,也不是纯挂名,而是苹果主导架构、能力定义、隐私设计和端侧适配,阿里出算力、中文语料、本地知识增强、安全对齐和评测闭环。说白了,就是苹果想当“总导演”,阿里是“制片+场地+方言顾问”。
有意思的是,这模型不叫“千问Lite”,也没冠名“Apple×Qwen”。它走的是苹果AFM 3那套路子:端云协同、大小分工。比如那个30亿参数的AFM 3 Core,就蹲在iPhone本地跑,回消息、改错字、写备忘录,快得像呼吸一样自然;而更重的任务——比如长文总结、多图理解、复杂推理——可能交给云端的稀疏大模型,或者直接切到千问。百度的技术也没出局,还在搜索和视觉模块里留着接口。一句话:国行Apple Intelligence不是单选题,是“苹果小脑+阿里大脑+百度眼睛”的组合拳。
为什么非得这么折腾?因为监管真卡脖子,用户也早不买账了。OpenAI进不来,Gemini不能用,光靠调用别人API,数据出境风险、响应延迟、功能阉割全得认。今年7月,“Apple智能”服务刚通过国家网信办备案,是实打实的合规通行证。而阿里从2025年初就深度参与,光模型调优和安全校验就干了一年多。华为Mate60系列的盘古小艺、小米的澎湃OS AI已经跑在前面,苹果再不拿出点“自己动手”的诚意,连发布会PPT都难写得硬气。现在这条路走通了,它就成了全球第一家在中国完成自研大模型落地审批的海外科技公司——不是“用”,而是“练”出来、“管”得住、“跑”得稳。
这事儿背后,其实藏着苹果对中国用户习惯的重新理解。以前大家吐槽Siri“听不懂人话”,不是它笨,是训练数据里缺了太多中国人的日常表达——比如“把微信那个文件发给王姐,顺便问她今晚火锅还来不来”这种带场景、带关系、带语气的长句,老外模型真容易卡壳。现在阿里提供的中文语料库,光是电商评论、小红书笔记、抖音弹幕、政务热线录音就超200TB,连“绝绝子”和“尊嘟假嘟”怎么用才不翻车,都标好了语境标签。苹果工程师自己也蹲在深圳华强北录了三个月商户对话,就为搞懂“扫码付不了是不是我手机太老”这类真实问题。
更实在的是隐私设计。AFM 3 Core所有文本处理全在设备端完成,连键盘输入法里的联想词都走本地神经网络,不上传、不留痕。国家网信办备案材料里白纸黑字写着:用户语音转文字后,原始音频自动粉碎;AI生成内容带不可见水印,一旦被用于造谣传谣,溯源系统3秒内可定位到具体设备ID。这不是嘴上说说,而是工信部《生成式AI服务安全基本要求》第5.2条强制落地的结果。
还有个细节很多人没注意:国行iPhone 16系列出厂预装的“智能助理”图标,点进去第一屏没有广告、没有会员入口、不推App Store下载,只有一句提示:“你的AI,只为你服务。”这背后是《互联网信息服务深度合成管理规定》的要求,也是苹果第一次在中国放弃“流量变现优先”的老路。据供应链消息,首批搭载该模型的iOS 18.2测试版已在深圳、杭州、成都三地千名教师、医生、社区工作者中灰度推送——他们反馈最多的一句话是:“终于不用教手机怎么听懂我了。”
说到底,这不是一场技术秀,而是一次信任重建。当国外大模型还在纠结“要不要加中国节日彩蛋”时,苹果和阿里已经把“春节拜年话术优化”写进了第三版训练指令集。真正的本地化,从来不是翻译软件,而是听得懂你叹气的语气,接得住你半截话里的潜台词,记得住你妈上次说“别总点外卖”的叮嘱——然后默默把健康食谱推到备忘录首页。
科元网提示:文章来自网络,不代表本站观点。